
koruriデータベースのアルゴリズム †名詞注目パース †koruriはオープンソースの形態素解析エンジンmecabを使って、文章を解析しその結果を保存しますが基本「名詞」にのみ注目をします。 これは名詞をランダムで入れ替えるだけのランダム作文ゲームからスタートしているからですが、名詞だけでも十分文章の特徴を出すことができるためそこだけに注視するようにしました。また「名詞」と「その他」で割り切ることで、扱う要素も簡素なレベルで押さえられるといった軽さも持っています。
るりぺこ。のアルゴリズム †るりぺこ。のアルゴリズムはVer0.2までランダムテンプレート型でした。ただ単純に文章中の名詞をランダムに入れ替えたものを生成するといった内容。 でもそれでは意味のある文章になかなかなってくれないので、名詞の連続移行のあたりから確率統計的な推移パターンを導入しました。過去のデータを元にしたマルコフ連鎖による過程推測です。 現在は全てのパーツ間を過程推測で繋いでいるため、意味はありませんが文章にはなっているというパターンが多くなっています。今後、統計情報がたまるほど精度が上がっていくといった期待が持たれます。 Ver 0.3以降 のアルゴリズム †名詞注目型生成 †るりぺこ。が文章を生成する際、必ず1つの名詞を与えます。この名詞をタネにそれ以降を繋げていくことで、一つの文章を生成する形です。 このタネとなる名詞を「注目語」と呼んでいます。 注目語を今話題の単語に設定することで、流れに乗っているような文を生成することができます。また反応元から名詞を抽出してそれを注目語に設定することで、返事をしたり、コメントをつけたりといった「外していない流れに乗った」文章を生成する事が可能になります。 特に状態がないときの注目語は完全ランダムで選出されますが、後の文節が続かないと意味がないのである程度後続リンクを多く持つ名詞を選出しています。 統計的連続名詞過程 †名詞をランダムに選出して入れ替えるというのがるりぺこ。の初出でしたが、本当にランダムな名詞だと文が発散して全く意味を持たないということがわかりました。このため、ある程度一緒に出現する名詞群のクラスター化というのを最初に実装します。
3から1といった逆方向については扱いません。
これにより名詞の指すモノが発散しにくくなり、まとまった文が構成されやすくなります。 統計的連続文節過程 †るりぺこ。は「名詞」と「名詞follower(その他)」といった二つの品詞を組み上げて文を作りますが、この名詞とfollowerの間での意味連続性を保つために「この名詞の後にはこのfollowerが続きやすい」というリンク情報も抽出し利用することにしました。
同じように(follower→名詞)というリンク情報も収集しており、これらを交互に繋いでいくことで一つの文を生成することになります。 (follower→名詞)情報から候補を選ぶ際、先の統計的連続名詞過程に即した「後続しやすい名詞」をさらに条件として選択することでよりそれっぽい文章生成となります。 注目語の任意配置 †Ver0.4.02までは注目語が必ず文の先頭に来る形でした。先の統計的連続過程がどれも順方向のみだったからというのも理由の一つです。 ですが、同じ語句を注目語として連続させたときに同じ名詞が必ず先頭にあるというのはいまひとつ深みに欠けますし、何が注目語だったのかが丸わかりでいささか興ざめするところでもありました。
注目語が先頭以外の所に登場することで、倒置法のような味がでたり別な単語から注目語へスライドしていくような効果が現れる、ときもあります。 連続過程で使う統計情報は変わりませんが、順方向で展開するか逆方向で展開するかといったルーチンを二つ用意することで機能を実現しています。 Ver 0.2 までのアルゴリズム †テンプレート †koruriでいうテンプレートとは、収集した文から名詞を取り去りその穴をワイルドカードで埋めておいた文章の元を指します。 通常の意味の通った文が最初にあって、その名詞部分をめちゃくちゃに入れ替えたものをるりぺこ。はさえずっています。
テンプレートの選出 †現在のところ、テンプレートもランダムに選出しています。 ただし、テンプレート自体意味不明だったり名詞が一つだけとか文をなさないものもありますので、手作業でスコアリングして使えないテンプレートはマイナススコアにしておき選ばれないようにしています。 文章の連結 †実際に収集した文からテンプレートを生成していますが、一言二言といった短文が多くなる傾向にあります。 「(*)だ」みたいに極端に短いテンプレートだと面白みにかけるしそれがランダム作文であっても意味をなさないため、一回の生成でいくつの名詞を使うかといった制約をつけました。 現在のところ、毎回2〜6個(数はランダム)の名詞を含んだ文にすることと内部で決めており、選出したテンプレートに含まれる名詞数がそれより少ない場合はさらにテンプレートを選出して後ろに結合していきます。 結合時、前のテンプレートが句読点で終わっていたらそのままくっつけます。句読点なしで終わっていた場合は「、」を間にはさみます。 これにより複文節あるように見える文が生成されますが、大抵の場合意味が連続していませんのでとんちんかんなテイストとなります。 |
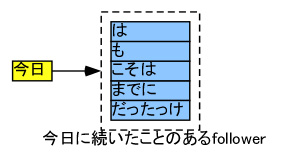 fig6.jpg 245件
[詳細]
 fig7.jpg 252件
[詳細]
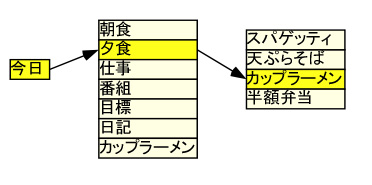 fig5.jpg 244件
[詳細]
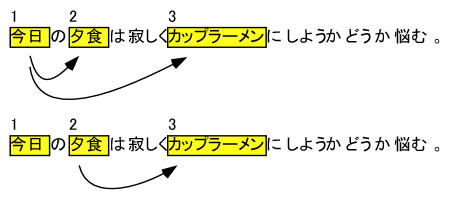 fig4.jpg 252件
[詳細]
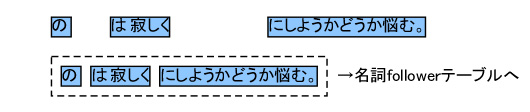 fig2.jpg 253件
[詳細]
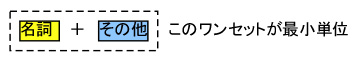 fig3.jpg 242件
[詳細]
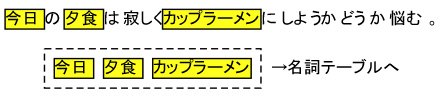 fig1.jpg 255件
[詳細]